Anonymisation sur site
Protégez vos données sensibles avant qu'elles ne quittent votre infrastructure.
Vous devez partager, archiver ou transmettre des données et des documents vers des applications et des systèmes d'IA sans en exposer les informations personnelles ou réglementées. Mais faire appel à un service externe d'anonymisation ou de pseudonymisation implique de faire sortir ces données critiques de votre environnement sécurisé.
La plateforme sur site de GenerIA traite vos données et documents directement au cœur de votre infrastructure, y compris sur vos propres serveurs. Disponible immédiatement sous forme d'image Docker, elle s'installe en quelques minutes et s'utilise facilement via une API ou une interface Web intégrée.
Notre plateforme prend en charge les formats bureautiques standards, les courriels avec pièces jointes et les archives ZIP ou TAR. Elle allie une grande simplicité d'utilisation à la souveraineté, la sécurité, l'explicabilité, la frugalité et les capacités de spécialisation qui rendent les produits GenerIA unqiues.
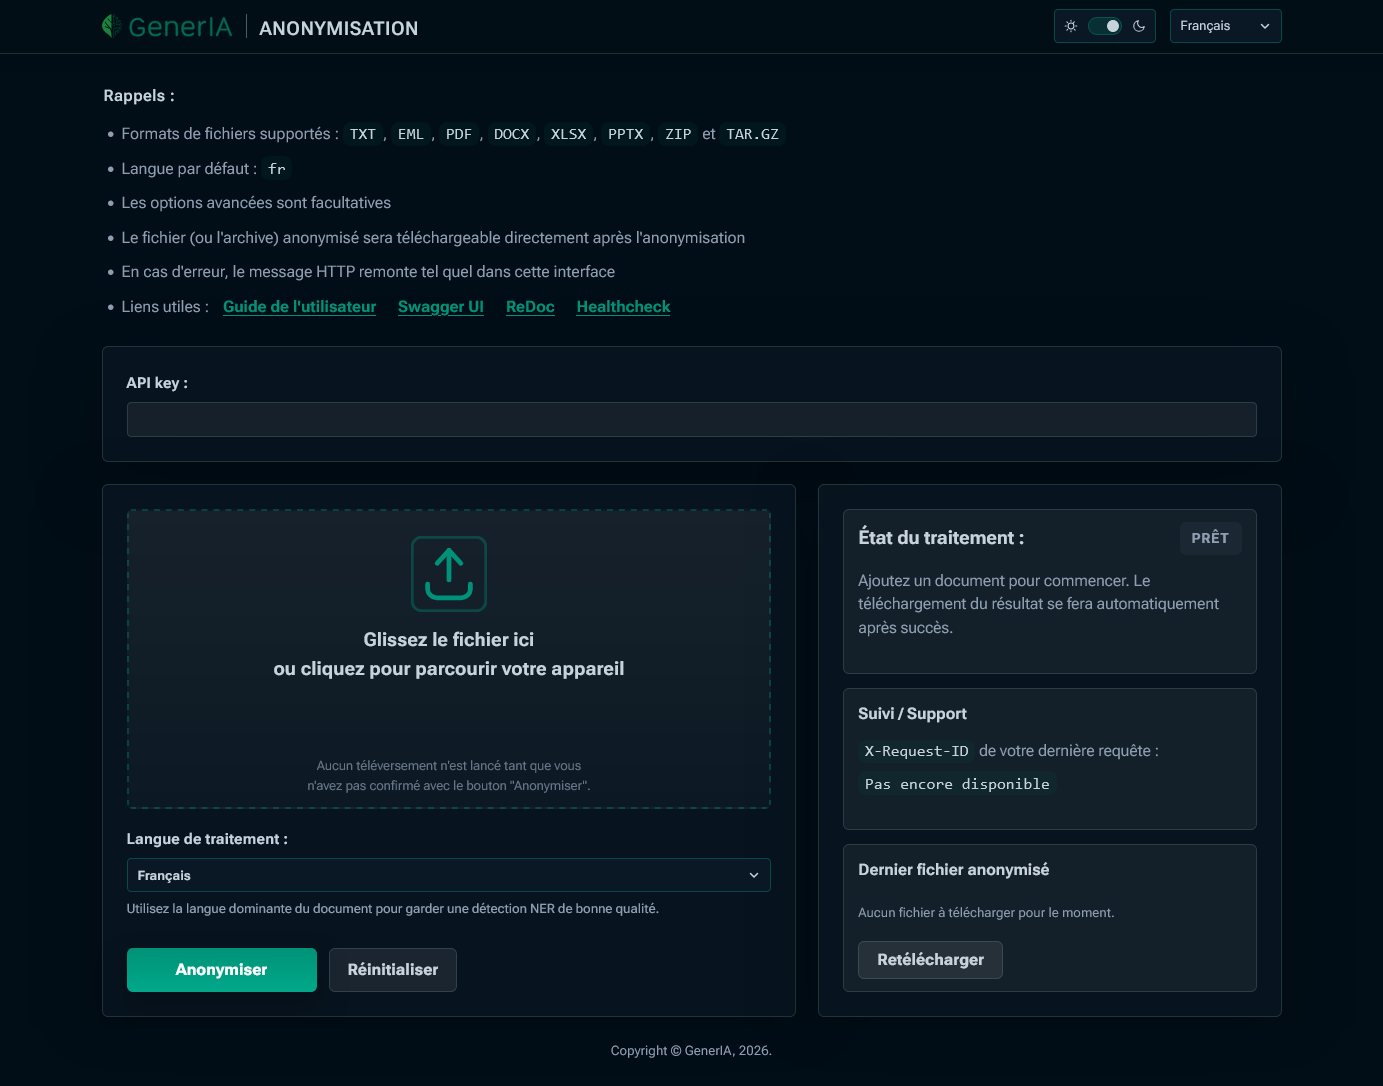
L'interface Web d'anonymisation GenerIA est particulièrement facile à utiliser car elle réduit les interactions au strict minimum : chargez ou déposez un fichier, cliquez sur le bouton et... voilà !
Protégez vos données sensibles là où elles se trouvent
Ne transmettez plus vos données confidentielles à des services externes pour assurer leur protection. La plateforme d'anonymisation et de pseudonymisation GenerIA réalise la détection, l'extraction, la reconnaissance optique de caractères (OCR), l'anonymisation et la reconstruction des documents en local. Fichiers sources et résultats restent dans l'infrastructure, le périmètre réseau et la juridiction choisis par votre organisation. Aucun modèle tiers, service d'IA ou nuage public n'est sollicité. Une fois installée, l'API ne transmet aucune donnée ni télémétrie à GenerIA.
Véritable passerelle de protection, l'API anonymise vos documents avant leur partage, transfert, analyse, intégration dans des jeux de tests ou transmission à d'autres IA. Votre organisation conserve le contrôle total sur le déploiement, les accès, les catégories d'informations traitées, la conservation et la traçabilité. Les règles de protection de la vie privée et de minimisation des données (RGPD, loi 25...) sont appliqués par conception, sans perturber vos processus existants.
En savoir plus
Aucun traitement externe - Détection, extraction, OCR, anonymisation et reconstruction des fichiers s'exécutent sur votre site ou dans tout nuage privé sous votre contrôle. L'API ne nécessite aucun envoi de contenu vers des services tiers, quels qu'ils soient.
Aucune donnée ni télémétrie transmise à GenerIA - Une fois déployée, l'API fonctionne de manière totalement autonome sans transmettre la moindre télémétrie à GenerIA. Nous n'avons aucune visibilité sur vos charges de travail ou l'activité de la plateforme. Tout partage d'information à fin d'analyse ou de support nécessite une action explicite intentionnelle de votre part.
Une passerelle de protection pour vos autres systèmes - L'API anonymise vos données et documents avant leur partage avec des partenaires, leur transfert entre environnements, leur intégration dans des jeux de test, leur analyse ou leur soumission à des applications d'IA internes ou externes. Vos flux de travail existants restent inchangés mais l'exposition de données sensibles est gérée.
Anonymisation ou pseudonymisation selon vos usages - Le service peut supprimer, masquer ou généraliser les identifiants détectés lorsqu'aucun lien de suivi n'est requis, ou les remplacer par des pseudonymes lorsque la continuité entre plusieurs documents est nécessaire. Un même identifiant peut conserver un pseudonyme constant au sein d'un document, d'un lot ou d'un déploiement complet, ou recevoir des pseudonymes distincts pour éviter tout croisement. Les pseudonymes prennent la forme d'identifiants techniques ou de valeurs synthétiques réalistes. Un mécanisme de ré-identification contrôlé peut être conservé si besoin, ou totalement omis lorsque le traitement ne le nécessite pas.
C'est vous qui gouvernez - Votre organisation définit le lieu d'exécution du service, les accès autorisés, les catégories d'entités traitées et les règles de conservation des fichiers. L'authentification peut être gérée par clés d'API, tandis que le contrôle d'accès au réseau reste celui de votre infrastructure.
Conformité aux obligations de confidentialité - L'anonymisation et la pseudonymisation sur site implémentent nativement les règles de respect de la vie privée, de confidentialité et de minimisation des données (Loi 25, RGPD, etc.). Les deux approches répondent toutefois à des objectifs distincts : l'anonymisation empêche toute ré-identification tandis que la pseudonymisation remplace les identifiants en permettant une ré-attribution via des informations séparées. Les données pseudonymisées restent donc des données personnelles. Ces approches contribuent distinctement à votre conformité sans se substituer à l'évaluation globale des risques et des règles d'accès.
Traçabilité interne sans fuite de données - Chaque réponse inclut un en-tête X-Request-ID permettant d'associer les résultats visibles, l'activité applicative et les procédures de support. Les données d'exploitation restent accessibles à vos équipes sans aucun export de contenu ou de télémétrie vers l'extérieur.
Une seule API pour vos documents, courriels et archives
Les informations d'affaires se présentent sous des formes très diverses. Un point d'entrée unique anonymise vos documents bureautiques courants, vos fichiers PDF, vos textes bruts, vos courriels avec pièces jointes et vos archives ZIP, TAR ou TAR.GZ. Le traitement et la reconstruction préservent la structure et la mise en page d'origine : vos documents restent directement exploitables au lieu d'être réduits à du texte brut sans mise en forme.
L'anonymisation s'étend bien au-delà du texte visible en traitant les en-têtes de courriels, commentaires, feuilles de clacul masquées, notes de présentation, métadonnées et hyperliens sensibles, avec reconnaissance optique de racarctères sur les PDF si nécessaire. Dans les fichiers PDF anonymisés, les informations confidentielles sont éléminées totalement : les documents sont en effet régénérés au lieu que de simples masques visuels leur soient ajoutés (ce qui rendrait les données d'origine techniquement récupérables). La détection prend en charge le français, l'anglais et l'espagnol, tandis que les catégories d'entités, les textes de remplacement et les noms de fichiers sont entièrement configurables.
En savoir plus
Formats bureautiques standards - Sont pris en charge les formats PDF, TXT, Microsoft Word, Excel et PowerPoint, y compris les formats récents Office Open XML. Le traitement respecte la structure native des documents afin de supprimer les données sensibles sans dégrader la mise en page.
Masquage définitif par régénération PDF - Lors de la détection de contenu sensible dans un PDF, nous appliquons une régénération complète du document plutôt que le placement d'un masque noir sur un texte resté sous-jacent. L'objectif est de supprimer totalement l'information confidentielle du fichier produit.
Traitement des contenus cachés et métadonnées - Commentaires Word et Excel, feuilles masquées, notes de présentateur PowerPoint et commentaires Microsoft 365 sont nettoyés au même titre que le corps du document. Les métadonnées courantes OOXML sont nettoyées et les hyperliens sensibles sont neutralisés.
Traitement complet des courriels EML - En-têtes sensibles, corps de messages en texte brut ou HTML sont anonymisés. Les pièces jointes dont le format est pris en charge sont traitées individuellement (avec passage en OCR pour les PDF si besoin) avant la reconstruction complète du message EML pour archivage ou réutilisation dans vos processus applicatifs.
Archives ZIP, TAR et TAR.GZ - Les fichiers contenus dans une archive sont traités sans modifier l'arborescence de l'archive d'origine. Les fichiers non pris en charge sont conservés à l'identique, ce qui permet de traiter des lots hétérogènes sans manipulation ni reconstruction manuelle.
Détection multilingue des entités - Le français, l'anglais et l'espagnol sont supportés nativement (le français est la langue par défaut lorsqu'aucun paramètre de langue n'est associée à une requête). D'autres langues peuvent être ajoutées sur demande. Les catégories d'entités à rechercher peuvent être spécifiées par langue pour chaque traitement.
Stratégies de protection et de remplacement configurables - Vous pouvez utiliser le masque par défaut de la langue, définir des textes de remplacement personnalisés ou demander des pseudonymes (identifiants techniques ou valeurs synthétiques réalistes). La cohérence des pseudonymes peut être appliquée à un document, un lot ou l'ensemble du déploiement, avec option de ré-identification contrôlée. Vous pouvez également imposer le nom du fichier de sortie : le service garantit la cohérence de l'extension avec le format réel du contenu.
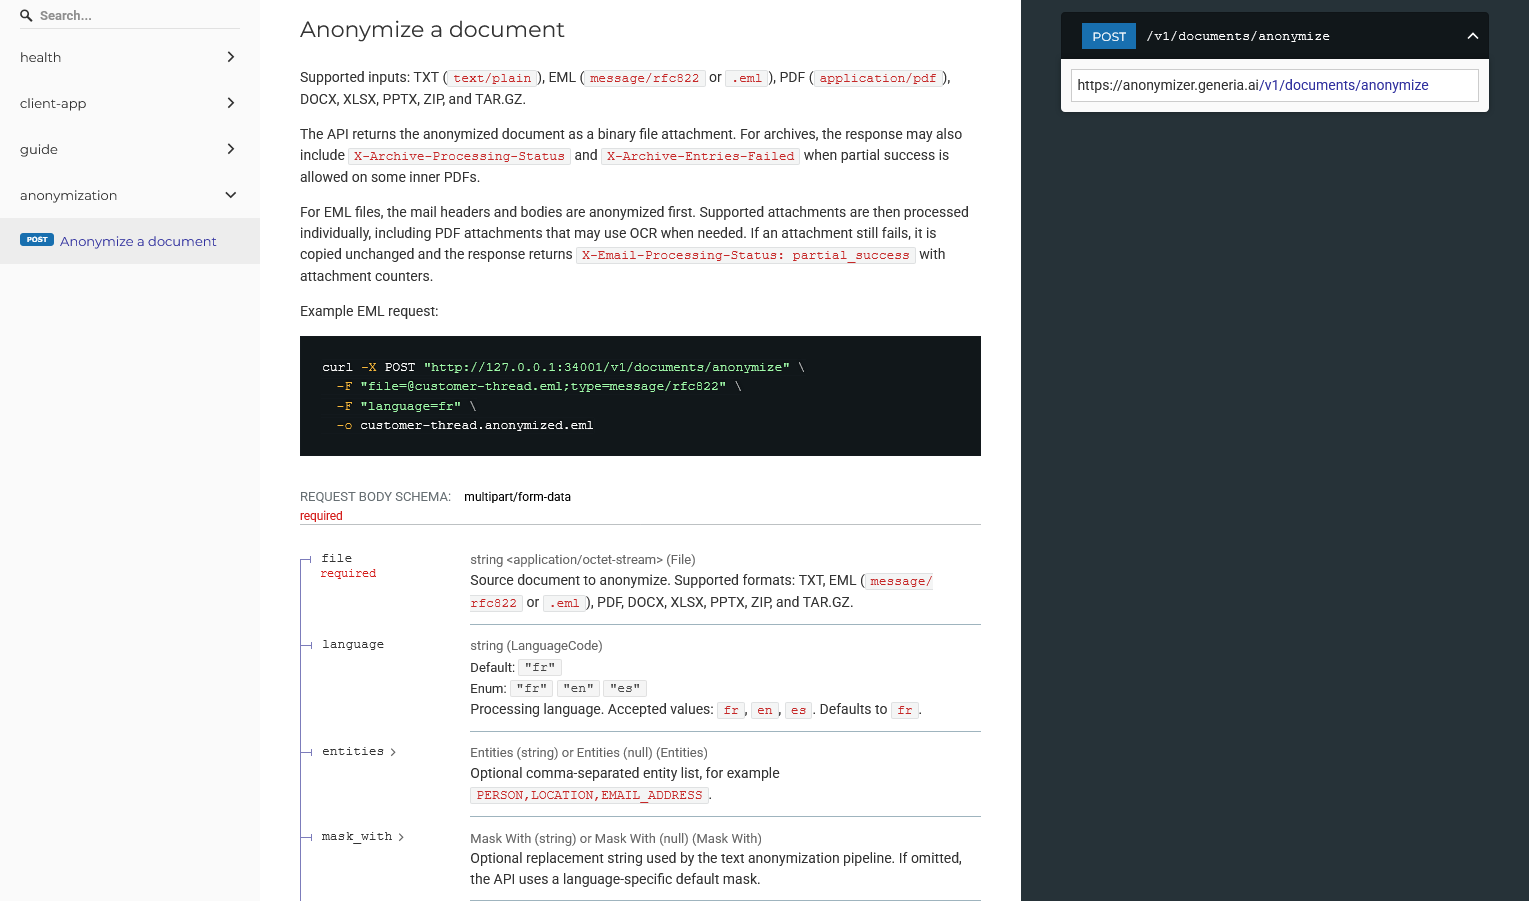
La plateforme d'anonymisation GenerIA inclut plusieurs guides techniques (comme l'interface ReDoc ci-dessus) qui simplifient son intégration dans vos applications et flux de travail existants.
Prête à déployer, simple à intégrer
La plateforme d'anonymisation de GenerIA est livrée avec une empreinte opérationnelle minimale : une image Docker et un fichier Docker Compose pour la mettre en oeuvre. C'est tout. Disponible en versions optimisées GPU ou 100 % CPU, elle se déploie de manière reproductible sur vos serveurs, vos centres de données privés, vos hébergements souverains ou toute infrastructure compatible Docker, sans dépendre d'un système propriétaire.
Une fois le service installé, il s'utilise soit via l'interface Web incluse, soit à partir de scripts en ligne de commande (Bash) pour traiter des arborescences complètes, soit directement depuis vos applications métiers via l'API HTTP. Les documentations intégrées OpenAPI, Swagger UI et ReDoc facilitent le développement et l'intégration. Dans tous les cas, votre organisation conserve le le contrôle de l'exposition réseau, de l'authentification, du stockage et de la supervision.
En savoir plus
Deux variantes de déploiement - Une version optimisée GPU est disponible pour les infrastructures nécessitant une accélération matérielle et un traitement à haut débit. La version CPU est conçue pour les organisations, les environnements isolés et les charges de travail qui n'ont pas l'utilité ou ne disposent pas d'un GPU.
Un point d'entrée principal - Vos applications soumettent les fichiers au point d'accès POST /v1/documents/anonymize. Des paramètres optionnels permettent de sélectionner la langue, les catégories d'entités, le texte de remplacement, le nommage de sortie, etc. Une requête minimale reste donc extrêmement simple, sans empêcher les intégrations qui nécessitent un contrôle plus fin.
Traitements par lots scriptables - Accessible par de simples appels HTTP, l'API s'intègre facilement dans des scripts Bash ou d'autres automatisations. Une seule commande peut parcourir un dossier et ses sous-répertoires, soumettre les fichiers pris en charge et enregistrer les documents anonymisés. C'est idéal pour traiter des collections documentaires, automatiser des tâches récurrentes ou enrichir vos chaînes de traitement sans développer d'application spécifique.
Interface Web incluse - Les utilisateurs peuvent glisser-déposer un document, renseigner une clé d'API si nécessaire, choisir la langue, lancer l'anonymisation et télécharger le résultat directement. L'interface affiche le statut du traitement et le dernier X-Request-ID pour faciliter le support et la corrélation des requêtes.
Auto-documentation intégrée - Outre la définition JSON OpenAPI, les documentations Swagger UI et ReDoc sont directement accessibles depuis l'interface Web et mises à jour automatiquement à chaque évolution de la plateforme. Vos équipes de développement peuvent ainsi tester et intégrer le service sans craindre de devoir se battre avec documentation obsolète.
Compatible avec vos flux existants - L'API HTTP s'appelle depuis vos applications métiers, GED, processus ETL, chaînes d'ingestion RAG, passerelles d'IA ou processus de conformité. La plateforme GenerIA apporte une brique d'anonymisation et de pseudonymisation performante sans imposer aucune nouvelle application aux utilisateurs.
L'infrastructure rste la côtre - Parce qu'il est conteneurisé, le service peut fonctionner indifféremment sur vos serveurs, vos nuages privés, vos hébergeurs souverains ou tout environnement compatible Docker. L'exposition réseau, la gestion des certificats TLS, le contrôle d'accès, le stockage et le suivi restent entièrement sous votre contrôle.
Fiabilité opérationnelle de bout en bout
Le traitement documentaire doit rester prévisible, même lorsque les fichiers sont hétérogènes, partiellement lisibles ou ne contiennent aucune entité sensible. Plutôt que de considérer chaque opération comme un succès ou un échec binaire, la plateforme d'anonymisation GenerIA retourne des états explicites et préserve le contenu exploitable dès que possible. Les pièces jointes et les fichiers contenus dans une archive sont traités individuellement, ce qui permet aux systèmes automatisés d'identifier les résultats partiels et de décider d'accepter, de retraiter ou de rejeter un document.
Noms de fichiers prévisibles, erreurs HTTP explicites, identifiants de requêtes uniques et points de contrôle de disponibilité de l'API fournissent les indicateurs nécessaires aux environnements de production. Vos applications, vos répartiteurs de charge et vos orchestrateurs de processus peuvent ainsi vérifier la disponibilité du service et éviter de router du trafic vers une instance indisponible. Les déploiements CPU ou GPU se dimensionnent et se dupliquent facilement, en fonction de vos volumes documentaires et de vos contraintes de temps de réponse.
En savoir plus
Résultats exploitables même sans entité détectée - Un document ne contenant aucune donnée sensible est retourné sous le nom attendu. Selon le format, ses métadonnées, annotations, objets intégrés ou autres éléments intégrés sont traités sans régénérer inutilement un contenu par ailleurs inchangé.
Gestion maîtrisée des succès partiels - Les pièces jointes de courriels et les membres d'une archive sont traités individuellement. Des règles configurables de poursuite en cas d'erreur permettent de garder utilisable le lot en cours de traitement. Les métadonnées de la réponse signalent clairement ce résultat partiel, qui n'est jamais présenté silencieusement comme une réussite complète.
Informations de statut structurées - Pour les fichiers EML (courriels), les réponses détaillent le statut du traitement ainsi que le nombre de pièces jointes traitées, ignorées ou en échec. L'application appelante peut ainsi décider d'approuver automatiquement le document ou de le soumettre à une révision humaine.
Erreurs HTTP explicites - Les réponses de l'API, au standard HTTP, distinguent clairement un traitement réussi d'un défaut d'autorisation, d'une taille de fichier excessive, d'un format non supporté, d'un paramètre invalide ou d'une instance indisponible. L'interface web restitue directement ces messages pour faciliter les tests et le support.
Nommage des fichiers de sortie - Par défaut, les noms des fichiers générés reprennent le nom d'origine suffixé de la marque .anonymized, et préservent la double extension des archives TAR.GZ. Si un nom personnalisé est transmis, le service ajuste automatiquement l'extension au format réel de son contenu.
Contrôles de disponibilité et de fonctionnement - Le point d'accès GET /health confirme que le processus HTTP répond, tandis que GET /health/ready valide qu'une instance est fonctionnellement disponible avant que des charges de travail lui soient envoyées.
Conçu pour une montée en charge supervisée - Points de contrôle, identifiants de requêtes et architecture conteneurisée rendent le service compatible avec les répartiteurs de charge et orchestrateurs. Les instances CPU ou GPU peuvent être dimensionnées et dupliquées selon le volume de documents, la répartition des formats et vos objectifs de latence.
Disponible immédiatement, adaptable à vos besoins
L'API d'anonymisation GenerIA est un produit prêt à déployer, pas le point de départ d'un long projet de développement sur mesure. Si vos besoins correspondent aux langues, formats et catégories d'entité déjà pris en charge, vous pouvez installer et utiliser immédiatement l'édition CPU ou GPU. La livraison conteneurisée simplifie tout le parcours d'appropriation, depuis l'évaluation et les essais d'acceptation jusqu'à la mise en production.
Lorsqu'un besoin dépasse les fonctions standards, GenerIA peut adapter rapidement la plateforme à vos identifiants métiers, formats propriétaires, structures documentaires spécifiques ou politiques de sécurité internes. Vous conservez le même socle conteneurisé, la même logique d'API et les mêmes interfaces d'exploitation, tout en bénéficiant de capacités ajustées à vos documents, à votre modèle de risques et à vos systèmes en aval.
En savoir plus
L'édition standard est prête à l'emploi - Si vos besoins correspondent aux langues, formats et catégories gérés nativement par la plateforme, l'édition standard s'installe et s'utiliseimmédiatement. La livraison en format Docker simplifie l'installation et accélère les étapes d'évaluation, de recette et de mise en production. La plateforme est généralement opérationnelle en moins d'une journée.
Détection d'entités spécialisées - Le moteur de détection peut être optimisé pour vos identifiants métiers, terminologies sectorielles ou données sensibles non couvertes par les catégories standards. Vos données représentatives et la validation de vos experts servent de référence pour mesurer les gains en précision.
Prise en charge de formats sur mesure - De nouveaux analyseurs et composants de reconstruction peuvent être développés pour vos fichiers propriétaires ou métiers. La même approche s'applique lorsqu'un format standard contient des objets intégrés complexes.
Spécialisation sur la structure des documents - Formulaires récurrents, rapports, correspondances et modèles documentaires structurés bénéficient de logiques d'extraction et de validation dédiées. Cette prise en compte de la structure affine la détection et évite de mofifier inutilement le reste du contenu.
Comportements adaptés à vos processus - Règles de restitution, choix des entités, niveau d'exigence strict ou best-effort, authentification, journalisation et intégration s'ajustent à votre modèle de risques et aux applications que vous utilisez déjà.
Spécialisation sans perte de simplicité - La spécialisation enrichit le produit standard sans le transformer en une application particulière complexe à maintenir. Vous conservez le même modèle de conteneur, les mêmes principes d'API, les mêmes interfaces et les mêmes documentations, avec les capacités supplémentaires qu'exigent vos cas d'usage.
L'ingénierie GenerIA
Il ne suffit pas d'appliquer un modèle de reconnaissance d'entités nommées au texte extrait pour obtenir une anonymisation fiable. La plateforme GenerIA commence par valider les fichiers et les paramètres reçus, puis confie chaque format à un gestionnaire spécialisé. Ensuite, elle combine les modèles d'entités multilingues, les règles déterministes, la détection contextuelle et l'OCR lorsque c'est nécessaire. Enfin, elle réécrit les documents en respectant leur structure, réassemble les courriels et les archives, et nettoie métadonnées, commentaires, contenus cachés, hyperliens et pièces jointes. Pour les PDF, la réécriture régénérative supprime définitivement les données sensibles du contenu sous-jacent.
Conçu comme un système de production industriel, notre plateforme gère de manière explicite les échecs, les éléments ignorés et les succès partiels. Les versions CPU et GPU s'ajustent automatiquement selon vos types de documents et vos objectifs de débit, tandis que les points de contrôle de santé, les journaux locaux et les identifiants de requêtes facilitent la supervision. Avant chaque livraison standard ou spécialisée, des tests d'évaluation versionnés mesurent la qualité de détection, la préservation de l'intégrité documentaire, la non-régression, la latence et la consommation de ressources.
En savoir plus
Identification et validation des formats - Le service contrôle les types MIME, les extensions et les paramètres avant de confier le fichier au module adapté. Des limites de taille et des parcours de rejet explicites évitent d'engager des traitements ambigus sur des fichiers corrompus.
Détection multi-niveaux des entités sensibles - La reconnaissance d'entités nommées (NER) multilingue est combinée à des règles déterministes, des sélections d'entités configurables et une analyse contextuelle propre au format. A l'inverse de nombreuses autre solution concurrentes conçues autour d'un dtecteur unique, cette approche multi-niveaux équilibre couverture et précision.
Génération de pseudonymes et contrôle de la ré-identification - Les règles de pseudonymisation gèrent indépendamment le format de remplacement, la portée de la cohérence et la possibilité de ré-identification contrôlée. La chaîne de traitement peut maintenir un lien stable pour une entité au sein d'un document, d'un lot ou d'un déploiement complet, ou générer délibérément des pseudonymes indépendants. Lorsque la ré-identification est activée, les clés de correspondance sont isolées du contenu et protégées par des contrôles d'accès stricts. Dans le cas contraire, aucune table de correspondance n'est conservée. Cette flexibilité préserve la valeur d'analyse des données et évite toute fuite d'identité.
Traitement documentaire intégrant l'OCR - Les PDF sans texte exploitable (PDF de type image) sont OCRisés localement, y compris lorsqu'ils sont joints à un courriel. Avant qu'une instance soit mise en service, les contrôles de préparation vérifient la disponibilité des dépendances OCR nécessaires.
Réécriture régénérative des contenus - Lorsqu'un PDF contient du texte sensible, ses contenus sont re-générés sur la même base structurelle : cette approche est beaucoup plus sûre que la simple application d'un masque superficiel. Les documents Office et les fichiers texte sont eux aussi réécrits avec préservation du format : les données détectées sont remplacées et l'utilisabilité du document est préservée.
Nettoyage complet des structures Office - Les fichiers DOCX, XLSX et PPTX sont traités comme des paquets structurés OOXML. Corps de texte, commentaires, zones masquées, notes, hyperliens et propriétés du document sont nettoyés selon les règles définies pour chaque format.
Reconstruction EML respectant les structures MIME - Le traitement des courriels parcourt les en-têtes, les corps multiparties et les pièces jointes selon la structure MIME. Chaque pièce jointe dontle format est prs en charge passe par le gestionnaire correspondant avant que le message complet soit reconstruit avec des métadonnées de traitement explicites.
Parcours sécurisé des archives - Les archives ZIP, TAR et TAR.GZ sont décompressées dans des espaces de traitement isolés. Les fichiers pris en charge sont anonymisés ou pseudnymisés. Les autres sont gérés selon la politique définie. L'arborescence interne est fidèlement reproduite dans l'archive finale.
Métadonnées et éléments cachés - L'anonymisation s'étend aux données non visibles du corps des documents. Propriétés Office, métadonnées PDF, annotations, formulaires, fichiers intégrés et hyperliens sensibles sont traités ou supprimés selon le format.
Gestion explicite des erreurs et traitements partiels - Les échecs complets, les éléments ignorés et les résultats partiels sont représentés sans ambiguïté. Un problème récupérable touchant une pièce jointe ne peut donc pas être confondu avec une réussite totale. Vos stratégies déterminent ensuite si le résultat partiel est acceptable.
Exécution optimisée pour les CPU et les GPU - La plateforme GenerIA est disponible en deux variantes distinctes optimisées pour les deux environnements matériels ciblés. Le profilage, les limites de concurrence et les plafonds de ressources peuvent être ajustés en fonction des volumes de documents à traiter et à vos objectifs de débit.
Etat de santé, journaux et traçabilité des requêtes - Les contrôles de fonctionnement et de préparation ainsi que les identifiants propres à chaque requête fournissent aux systèmes de supervision, aux répartiteurs de charge et aux équipes de support toutes les données d'état dont ils ont besoin. Les journaux restent dans l'environnement contrôlé et sont conçus pour être compatibles avec les systèmes d'observabilité que vous utiliser déjà.
Qualité d'anonymisation mesurable - Des documents représentatifs, des jeux d'entités multilingues, des cas d'OCR, des contenus imbriqués et des entrées mal formées peuvent être réunis dans des suites d'évaluation versionnées. La qualité de la détection, l'intégrité documentaire, les régressions, la latence et l'utilisation des ressources sont ainsi évaluées ensemble avant chaque nouvelle version.
Le socle GenerIA, commun à toutes nos solutions
Cette solution bénéficie des mêmes avantages technologiques que toutes les autres solutions GenerIA.
Elle est, par conception :
Souveraine - Déployable sous votre contrôle, y compris sur site et dans des environnements totalement isolés
Explicable - Ses sources, justifications, métriques et traçabilité sont accessibles avec les résultats
Frugale - Des performances à l'état de l'art pour une consommation de ressources réduite au strict nécessaire
Éco‑transparente - Des métriques environnementales granulaires et des tableaux de bord vous aident à mesurer précisément votre impact
Flexible - Adaptable à votre infrastructure, à vos applications, à vos interfaces et à votre modèle de déploiement.
Découvrez également les fonctionnalités communes aux produits et solutions GenerIA , qui garantissent la réussite de vos projets, dans les délais convenus et à coût prévisible.
Anonymisez vos données sensibles sans les confier à autrui
La plateforme d'anonymisation GenerIA est disponible immédiatement en versions CPU et GPU. Nous pouvons vous aider à l'évaluer sur des documents représentatifs ou la spécialiser rapidement pour vos formats, vos structures de données et vos besoins d'anonymisation ou de pseudonymisation.
Échangeons sur votre projet