Le Blog GenerIA
Quand votre fournisseur d'IA devient votre concurrent
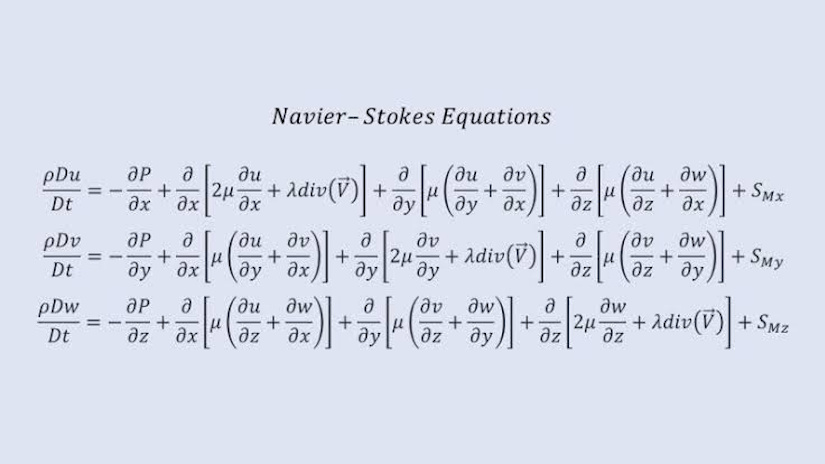
Un mathématicien a consacré un an à l'un des problèmes ouverts les plus difficiles de son domaine. Il a mené ce travail dans Codex, l'agent de codage d'OpenAI. Quelques jours avant sa publication, OpenAI a publié un résultat concurrent sur le même problème, suivant une voie tout aussi inhabituelle, mais avec une puissance de calcul "maison".
Le 8 septembre 2026, Tristan Buckmaster, professeur de mathématiques à l'université de New York, a rendu publiques trois démonstrations relatives au problème de l'explosion en temps fini en mécanique des fluides. Ce travail, mené avec Levent Alpöge et assisté tout au long du processus par des grands modèles de langage, s'accompagnait d'une déclaration décrivant une situation qui interroge : alors que leurs résultats étaient en cours de finalisation, il a appris que des informations concernant leurs avancées étaient parvenues à OpenAI. Peu après, OpenAI a publié une démonstration complète du problème de l'existence et de la régularité des solutions des équations de Navier-Stokes, l'un des sept problèmes du prix du Millénaire, chacun assorti d'une récompense d'un million de dollars attribuée par le Clay Mathematics Institute [1].
Les faits sont contestés et ils le resteront sans doute quelque temps. Ce qui ne l'est pas, en revanche, c'est la nature de l'exposition révélée par cette affaire. Et elle n'a rien de spécifiquement mathématique.
Ce qui est allégué et ce qui est démenti
Selon le récit de Buckmaster rapporté par TechCrunch [2], ses questions sur la date de lancement des travaux d'OpenAI et sur le degré d'intervention humaine impliqué ont reçu des réponses variables : une équipe entière travaillait déjà sur le problème ; un volume extraordinaire de calcul avait été mobilisé ; et le premier prompt n'aurait été envoyé qu'après que la rumeur de ses propres travaux a circulé. La voie qu'il avait empruntée avec Levent Alpöge n'était explorée par presque personne : ce n'était pas le type de direction qu'un modèle pouvait atteindre en quelques jours à partir du seul énoncé du problème. Lorsqu'il a envisagé de rendre l'affaire publique, il affirme que Sébastien Bubeck, responsable de la recherche mathématique chez OpenAI, lui a demandé pourquoi il voudrait ruiner sa carrière, avant d'indiquer qu'il n'était pas tenu de rester conciliant concernant ses affirmations.
Bubeck qualifie en effet ces accusations de fausses et d'inflammatoires, et affirme avoir agi conformément aux usages académiques. OpenAI déclare que ses travaux ont commencé le 1er septembre, après avoir entendu une rumeur, et qu'aucun de ses chercheurs ou agents n'a vu le travail des deux mathématiciens avant publication.
Tristan Buckmaster fait preuve de prudence sur ce point. Il n'a pas vu la démonstration concurrente, ne sait pas ce que le modèle a fait ni si ses données ont pu jouer le moindre rôle, et il précise clairement qu'il n'accuse personne. Il consigne seulement ce qui lui a été dit, et à quel moment. C'est précisément cette retenue qui rend l'épisode si instructif. Même en écartant toutes les affirmations contestées, un fait structurel demeure.
Leur modèle, leurs serveurs, leurs règles
Tristan Buckmaster et Levent Alpöge ont travaillé dans Codex. Leurs ébauches de démonstrations, leurs tentatives infructueuses, leurs notes de travail - c'est-à-dire les traces intellectuelles d'une année d'efforts orientés - se sont accumulées au sein d'un produit exploité par une organisation qui intervient elle aussi dans le même espace intellectuel. OpenAI se réserve le droit d'entraîner ses modèles à partir de telles interactions ; les utilisateurs peuvent s'y opposer (opt-out), mais ce n'est pas l'option par défaut.
Mesurons bien ce que cela implique. Même si la version d'OpenAI est exacte dans tous ses détails, les chercheurs ne disposent d'aucun moyen indépendant de l'établir avec certitude. Ils ne peuvent pas auditer la barrière entre les capacités propres du modèle et les informations issues de leurs prompts. Ils ne peuvent pas démontrer que leurs travaux sont restés protégés. Il ne leur reste qu'une assurance, sans aucun instrument permettant d'en établir la véracité.
Une organisation incapable de vérifier une telle protection n'en dispose pas réellement. Elle dispose au mieux d'une promesse. Et comme chacun sait, les promesses sont parfaitement suffisantes jusqu'au moment où les intérêts divergent. La leçon de cet épisode est que les intérêts d'une plateforme et de ses utilisateurs les plus sophistiqués divergent précisément lorsque le travail accompli par ces derniers prend de la valeur.
Presque personne ne chiffre le risque d'une IA qu'il ne contrôle pas
On pourrait être tenté de classer cette histoire dans la catégorie des querelles universitaires. Ce serait une erreur car l'affaire n'a rien d'académique.
Très peu d'organisations ont un problème du prix du Millénaire dans leur historique de conversations. Presque toutes, en revanche, ont des informations pour lesquelles un concurrent serait prêt à payer : un modèle de tarification basé sur trois ans de calibrage ; une documentation de processus propriétaire ; une architecture non encore divulguée ; des fichiers clients ; une note relative à une acquisition ; un dossier réglementaire qui n'a pas encore été déposé. Chaque jour, ces éléments sont copiés-collés dans des assistants généralistes par des personnes de bonne foi, en vertu de conditions que presque personne n'a lues.
Ces expositions de données n'ont rien d'exceptionnel. Elles résultent de la configuration par défaut de l'environnement moderne du travail intellectuel, dans lequel les informations non publiques les plus précieuses de l'organisation transitent, non chiffrées au point d'usage et ensuite invérifiables, par une infrastructure contrôlée par un tiers dont les ambitions commerciales sont immenses.
L'avantage du mathématicien est que son différend est devenu visible. Il a pour lui une date de publication, une contrepartie identifiée et une communauté académique capable de déterminer l'antériorité des travaux. Une entreprise industrielle de taille moyenne dont le savoir-faire de production améliore le modèle d'un concurrent ne bénéficie d'aucun de ces arguments. Elle constate simplement, dix-huit mois plus tard, que ce qui la distinguait s'est dilué, sans jamais savoir pourquoi.
Ce qu'est la souveraineté réellement
La bonne réponse n'est pas de renoncer à l'IA. Tristan Buckmaster et Levent Alpöge ont obtenu leurs résultats avec l'assistance de modèles, ce qui n'a rien d'étonnant car les modèles en question fonctionnent. La réponse consiste à changer les règles selon lesquelles les modèles agissent.
C'est précisément la raison d'être de GenerIA.
Les IA de GenerIA fonctionnent là où vous le décidez. Nos systèmes sont conçus sur mesure et déployables sur site, au sein de votre propre infrastructure si vous le souhaitez. Ce ne sont pas des environnements "privés" dans le cloud de quelqu'un d'autre, et de ce fait votre garantie d'isolation des données sensibles est pleine et entière. La question de savoir si vos informations ont quitté vos locaux reçoit une réponse architecturale fiable, pas une promesse fondée sur une clause qu'on vous invite à croire sur parole.
Vos données n'entraînent aucun système autre que le vôtre. GenerIA n'a pas de modèle économique fondé sur l'agrégation de données, pas de produit grand public connexe à améliorer, pas d'intérêt à exploiter les données que vous nous confiez. Votre savoir-faire métier, vos fichiers clients, vos travaux non publiés... rien de tout cela ne devient la matière première d'un modèle qui servira ensuite à une autre entité. Il n'y a aucune option "opt out" à chercher, car il n'y a rien dont il faille opt out.
Vos intérêts et les nôtres ne sont pas en tension. GenerIA vend des systèmes ; elle ne vend pas ce que ces systèmes apprennent. Il s'agit d'un alignement structurel, pas d'une promesse de bonne conduite. Et seul un alignement structurel prévaut lorsque votre travail a de la valeur.
Cette sécurisation par conception n'impose aucun compromis fonctionnel. Un système développé pour votre usage, entraîné sur votre domaine et fonctionnant avec frugalité sur du matériel que vous contrôlez surpasse un géant généraliste dans les tâches qui comptent réellement pour votre organisation, sans qu'il soit nécessaire d'exposer vos secrets.
Conclusion
Vos données, votre IA, votre avantage concurrentiel.
Sources
[1] Clay Mathematics Institute, Millennium Problems
[2] TechCrunch OpenAI fought dirty on career-making math problem, says NYU mathematician
Références
Tristan Buckmaster,public statement accompanying the release of the proofs, September 8, 2026.
OpenAI,On the Navier-Stokes Millennium Prize Problem, September 2026.
OfficeChai,OpenAI's Sebastien Bubeck calls Tristan Buckmaster's claims "false and inflammatory", September 8, 2026.
WCCFTech,A mathematician working on the Navier-Stokes Millennium Prize problem now wonders if OpenAI stole his notes stored in Codex, September 8, 2026.
OpenAI,How your data is used to improve model performance (opt-out policy for Codex and API interactions).